


מה זה RAG? בינה מלאכותית שעונה מתוך המידע של העסק
מודלי שפה כמו ChatGPT, Claude ו-Gemini יודעים המון, אבל הם לא מכירים את העסק שלכם. מה זה RAG, איך הוא מחבר את ה-AI למסמכים ולמאגר הידע שלכם, ואיפה זה חוסך זמן וכסף בעסק – בדיוק על זה המדריך הזה.
מודלי שפה עובדים היטב עם כמויות גדולות של טקסט, אבל לא תמיד יש להם את המידע שנדרש למשימה מסוימת. הם לא מכירים את נהלי החברה, את מאגר הידע הפנימי, את חוזי הלקוחות או את הקבצים של המשתמשים.
אחת הדרכים לתת למודל גישה למידע הזה היא RAG. בגישה הזו משתמשים בעוזרים ארגוניים, בסוכני AI, בחיפוש במסמכים, בשירות לקוחות ובכל מערכת שצריכה לענות על סמך מקורות ספציפיים.
במדריך נעבור על:
- מה זה RAG ובמה הוא שונה ממודל שפה רגיל;
- איפה RAG עוזר לעסקים;
- איך מערכת RAG בנויה, שלב אחר שלב;
- איך סוכני AI משתמשים ב-RAG;
- איך מתחילים פרויקט RAG ואיך בודקים שהוא עונה נכון.
מה זה RAG ובמה הוא שונה ממודל שפה רגיל
RAG (ראשי תיבות של Retrieval-Augmented Generation, כלומר "יצירה מועשרת באחזור מידע") היא גישה לבניית מערכות בינה מלאכותית שבה מודל השפה מקבל, לפני שהוא עונה, מידע נוסף ממקורות חיצוניים – למשל מהמסמכים, ממאגר הידע או ממסד הנתונים של העסק.
מודל שפה רגיל עונה על סמך הידע שקיבל באימון ועל סמך מה שנכתב לו בשיחה. במערכת RAG נוסף שלב של חיפוש: המערכת קודם מוצאת מידע שקשור לשאלה של המשתמש, ורק אז מעבירה אותו למודל יחד עם השאלה עצמה.
מקור המידע יכול להיות מסמכים של החברה, מאגר ידע, קבצים של משתמשים, מסד נתונים או כל מקור אחר שהמערכת מחוברת אליו.
לדוגמה, עובד שואל את העוזר הארגוני מה הנוהל לבקשת חופשה. מודל שפה בלי הקשר נוסף יוכל לענות רק בכלליות. מערכת RAG קודם תמצא את הסעיף הרלוונטי בנוהל הפנימי, תעביר אותו למודל, והמודל יענה לפי הכללים של החברה הספציפית.
חשוב להבין: RAG הוא לא רשת נוירונים ולא מודל שפה נפרד. זו גישה ארכיטקטונית שמחברת כמה רכיבים: מקור מידע, מנגנון חיפוש ומודל שפה (LLM). החיפוש אחראי למצוא את המידע הרלוונטי, והמודל משתמש בו כהקשר כדי לנסח תשובה. לכן גם לא נכון להשוות "RAG מול LLM": ה-LLM הוא המודל שמייצר טקסט, ו-RAG הוא הדרך לארגן סביבו מערכת ולהזין אותו במידע חיצוני.
איפה RAG עוזר לעסקים
משתמשים ב-RAG בכל מערכת שצריכה לענות על סמך מידע ספציפי: מסמכים פנימיים, הוראות עבודה, חוזים, תיעוד טכני, מסדי נתונים ומקורות נוספים.
בוט שירות לקוחות שמכיר את המוצר
עוזר AI יכול לחפש תשובות בתיעוד של המוצר, בהוראות השימוש ובחומרים של צוות השירות. כך הוא עונה אוטומטית על שאלות נפוצות ומעביר לנציג רק את הפניות המורכבות. אם אתם רק מתחילים עם בוטים, קראו קודם את המדריך שלנו לצ'אטבוט לעסק.
מאגר ידע פנימי לעובדים
עובד שואל שאלה בשפה רגילה, והמערכת מוצאת את המידע במסמכים הפנימיים ומנסחת תשובה. כך אפשר לחפש נהלי חופשה, הוראות קליטה לעובדים חדשים או נהלי עבודה, בלי לחפור בתיקיות. אותו עיקרון עובד גם בשיווק: עוזר שמכיר את נתוני הלקוחות והמותג שלכם עוזר לבנות אסטרטגיה שיווקית עם AI על בסיס מידע אמיתי ולא כללי.
חיפוש וניתוח מסמכים
RAG מתאים לחיפוש מידע בחוזים, בדוחות, במפרטים טכניים ובארכיונים גדולים. למשל, אפשר לשאול מה התנאים לביטול הסכם, והמערכת תמצא את הסעיפים המתאימים ותנסח תשובה על בסיסם.
בתחומים שבהם מחיר הטעות גבוה, כמו רפואה ומשפטים, תשובות המערכת צריכות בדיקה נוספת של איש מקצוע. העובדה שיש מקור לא מבטיחה שהתשובה נכונה: המסמך יכול להיות לא מעודכן, החיפוש יכול לבחור קטע לא מתאים, והמודל יכול לפרש אותו לא נכון.
איך מערכת RAG בנויה: 3 שלבים
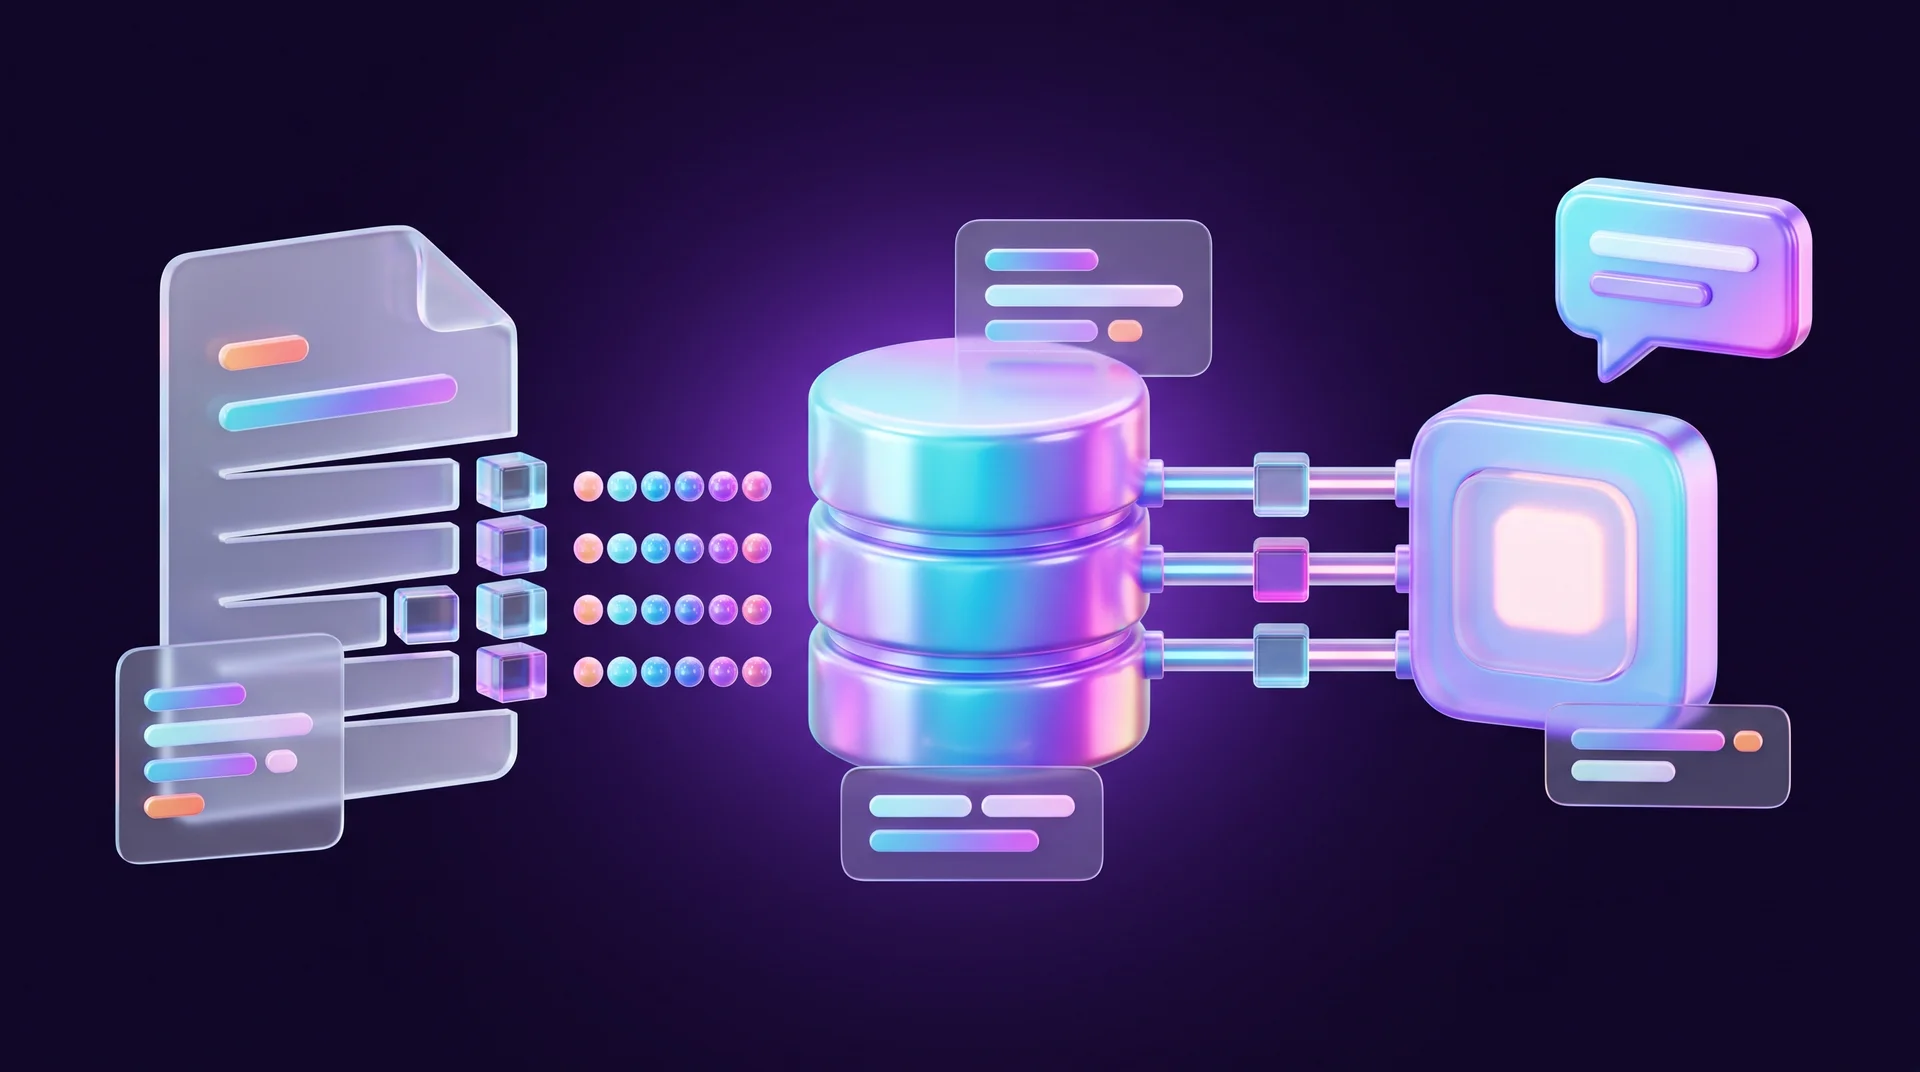
הארכיטקטורה תלויה במשימה, אבל המבנה הבסיסי כמעט תמיד זהה. המערכת מכינה את המידע, מחפשת בו לפי השאלה של המשתמש, ומעבירה את הקטעים שנמצאו למודל השפה כדי שינסח תשובה.
שלב 1: הכנת המידע וחלוקה לקטעים
מקורות המידע יכולים להיות מסמכים, מסדי נתונים, מערכות ארגוניות ושירותים נוספים. לפני החיפוש מנקים את המידע ומחלקים אותו לקטעים קטנים בעלי משמעות, שנקראים צ'אנקים (chunks).
לגודל הקטעים יש השפעה ישירה על איכות החיפוש. קטע גדול מדי מכיל הרבה מידע מיותר, וקטע קטן מדי מאבד את ההקשר. לכן את שיטת החלוקה מתאימים לסוג המסמכים ולמשימה, ובודקים אותה על שאלות אמיתיות.
לכל קטע אפשר להוסיף מטא-דאטה: שם המסמך, הפרק, מספר העמוד או קישור. המטא-דאטה עוזרת לסנן תוצאות ולהציג למשתמש על אילו מקורות התשובה מבוססת.
שלב 2: חיפוש לפי משמעות
אחת משיטות החיפוש המרכזיות ב-RAG היא חיפוש וקטורי. הטקסט הופך לאמבדינגים (embeddings) – ייצוג מספרי שמאפשר להשוות קטעי טקסט לפי המשמעות שלהם, ולא רק לפי המילים.
לדוגמה, השאלה "השרת לא מגיב" תתאים לקטע בתיעוד שכתוב בו "לא ניתן להתחבר לשרת", למרות שהניסוח שונה לגמרי. את הווקטורים שומרים במסד נתונים וקטורי כמו Pinecone, Qdrant או Supabase עם pgvector.
את הקטעים המתאימים בוחר רכיב שנקרא retriever. בחלק מהמערכות משלבים חיפוש וקטורי עם חיפוש טקסט מלא, כדי לתפוס גם את המשמעות וגם התאמות מדויקות, כמו קודי שגיאה, מספרי הזמנה או מק"טים. זה נקרא חיפוש היברידי. אפשר גם למיין מחדש את התוצאות (reranking) כדי להעביר למודל רק את הקטעים הרלוונטיים ביותר.
שלב 3: יצירת התשובה
אחרי החיפוש המערכת מצרפת את הקטעים שנמצאו לשאלה של המשתמש ומעבירה אותם למודל השפה, למשל GPT של OpenAI, Claude או Gemini. המודל משתמש בהקשר הזה כדי לנסח תשובה.
אם נשמרה מטא-דאטה, האפליקציה יכולה להציג את המסמכים, העמודים או הקישורים שעליהם התשובה מבוססת. במערכות מתקדמות מוסיפים גם בקרת הרשאות, סינון שאלות וכלי ניטור, כדי להגביל את הגישה למידע ולהבין למה המערכת נתנה תשובה שגויה.
סוכני AI ו-RAG: כשהעוזר גם פועל
במערכת RAG רגילה, המפתח קובע מראש את סדר הפעולות: לקבל שאלה, למצוא קטעים מתאימים במאגר הידע ולהעביר אותם למודל.
במערכת עם סוכן AI, חלק מההחלטות מקבל המודל עצמו. הסוכן יכול להחליט אם בכלל צריך חיפוש, לבחור את המקור המתאים, לשפר את השאילתה ולהחליט מה לעשות עם המידע שנמצא. RAG הופך לאחד מהכלים של הסוכן, לצד API, מסדי נתונים ושירותים אחרים. הגישה הזו נקראת Agentic RAG.
לדוגמה, עובד חדש שואל את העוזר הארגוני אילו מסמכים להביא ביום הראשון. מערכת RAG רגילה תמצא את הוראות הקליטה ותענה לפיהן. סוכן AI יכול ללכת רחוק יותר: למצוא את הכללים הכלליים דרך RAG, לפנות למערכת משאבי האנוש דרך API, לבדוק את התפקיד, המחלקה והמסמכים שכבר הוגשו, ולהכין רשימת משימות אישית. אם חסר מידע, הסוכן ינסח שאילתה חדשה ויחפש שוב, למשל הוראות ספציפיות למחלקה.
לסוכן אפשר גם לחבר זיכרון, כדי שיזכור מידע בין פעולות או שיחות. כך העוזר יידע אילו שלבי קליטה העובד כבר עבר ולא יציע אותם שוב.
תרחיש נפוץ נוסף הוא שירות לקוחות. RAG מוצא את ההוראה לפתרון התקלה, והסוכן בודק דרך API את סטטוס ההזמנה, את פרטי התשלום או פותח פנייה לנציג במערכת ה-CRM. כך המערכת לא רק עונה על שאלות, אלא גם מבצעת את הפעולות שקשורות אליהן.
איך מתחילים פרויקט RAG בעסק
לפני הפיתוח חשוב להחליט איזו משימה המערכת תפתור, איפה המידע נשמר, כל כמה זמן הוא מתעדכן והאם צריך להציג למשתמש קישורים למקורות. משם אפשר להתקדם בשלבים:
- בחרו תרחיש אחד ברור. למשל: מענה ללקוחות על סמך שאלות נפוצות, תנאי שירות ומדיניות החזרות. כדי לבחור נכון, כדאי לבדוק איך מתחרים ומובילים בתחום כבר משתמשים ב-AI – ראו את המדריך לבנצ'מרקינג לעסקים.
- אספו והכינו את המסמכים. ודאו שהם מעודכנים, בלי כפילויות ועם שמות ברורים. RAG טוב רק כמו המידע שמזינים לו.
- בחרו רכיבים. מודל אמבדינגים שתומך בעברית, מסד נתונים וקטורי ומודל שפה כמו GPT, Claude או Gemini. לבנייה מהירה יש גם ספריות מוכנות כמו LangChain ו-LlamaIndex.
- הנחו את המודל לענות רק מתוך ההקשר. כתבו בהוראות שאם אין מספיק מידע, המודל צריך לומר זאת ולא להמציא תשובה.
- בנו אב-טיפוס ובדקו אותו על שאלות אמיתיות. אב-טיפוס ראשון אפשר לבנות גם בסביבה חינמית כמו Google Colab, ולהוסיף לו ממשק צ'אט פשוט.
- חברו לערוצים ולמערכות. צ'אט באתר, וואטסאפ, CRM או כלי עבודה פנימיים, למשל בעזרת n8n או Make.
- תכננו עדכון שוטף והרשאות. מסמכים חדשים צריכים להיכנס למאגר אוטומטית, וכל משתמש צריך לראות רק את המידע שמותר לו.
איכות התשובה תלויה לא רק בחיפוש, אלא גם במודל עצמו. מודל קטן מדי עלול לנסח לא מדויק מידע שהחיפוש מצא נכון, ומעבר למודל חזק יותר משפר את הניסוח. ובכל זאת, גם מודל חזק לא מבטיח תשובה נכונה: התוצאה תלויה גם באיכות המסמכים, בחלוקה לקטעים, בחיפוש ובהוראות למודל.
איך בודקים שמערכת RAG עונה נכון
גם מערכת שנבנתה נכון לא תענה במדויק על כל שאלה. טעות יכולה לקרות בשני שלבים עיקריים: או שהמערכת מצאה מידע לא מתאים, או שמודל השפה השתמש לא נכון בהקשר שקיבל. לכן נוח לבדוק כל שלב בנפרד.
בדיקת החיפוש
אם המערכת לא מצאה את המידע הנכון, הבעיה בדרך כלל בשלב האחזור (retrieval). הסיבות יכולות להיות שונות: המידע בכלל לא קיים במסמכים, הטקסט חולק לקטעים בצורה לא טובה, מודל האמבדינגים לא מתאים היטב בין השאלה לתוכן, או שנכנסים לתוצאות יותר מדי קטעים לא רלוונטיים. לפעמים גם השאלה עצמה כללית מדי.
לבדיקת החיפוש משתמשים במדדים כמו Precision@K ו-Recall@K, כאשר K הוא מספר התוצאות הראשונות שבודקים. אם המערכת מעבירה למודל שלושה קטעים, אז K=3. מדד Precision@3 מראה כמה מתוך שלושת הקטעים באמת קשורים לשאלה: אם שניים מתוך שלושה רלוונטיים, הערך הוא 2/3. מדד Recall@3 מראה כמה מהקטעים הנחוצים המערכת הצליחה למצוא מתוך כל הקטעים הרלוונטיים במאגר. הוא חשוב במיוחד כשתשובה מלאה דורשת מידע מכמה מקומות.
בפועל, הכינו רשימה קצרה של שאלות בדיקה, סמנו מראש אילו מסמכים או קטעים צריכים להימצא לכל שאלה, ובדקו אם הם מופיעים בין התוצאות הראשונות.
בדיקת התשובה של המודל
אם החיפוש עובד טוב אבל התשובה הסופית שגויה, הבעיה בשלב היצירה. לכן כדאי לשאול על כל תשובה שתי שאלות נפרדות: האם המערכת מצאה את המידע הנכון? והאם המודל השתמש בו נכון?
אחד המדדים המרכזיים הוא faithfulness – עד כמה הטענות בתשובה נתמכות בהקשר שנמצא, והאם המודל לא הוסיף מידע שאין במקורות. מדד נוסף הוא answer relevance – האם המודל באמת עונה על השאלה ולא סוטה ממנה. לאוטומציה של הבדיקות האלה יש כלים כמו Ragas, DeepEval ו-TruLens, שמשתמשים במודל שפה נפרד כ"שופט".
אף מדד בודד לא מתאר את איכות המערכת כולה. תשובה יכולה להיות רלוונטית מאוד לשאלה ובכל זאת לכלול טענות שלא מופיעות במקורות, או להפך. לכן בדקו את כל השרשרת: שאלה, קטעים שנמצאו, הקשר שהועבר למודל ותשובה סופית. כך תבינו לא רק שהמערכת טעתה, אלא גם באיזה שלב.
איך RJL Studio בונה עוזרי AI על בסיס הידע של העסק
ב-RJL Studio אנחנו בונים עוזרי AI שעונים מתוך המידע של העסק שלכם: צ'אט באתר שמכיר את השירותים והמחירון, בוט לוואטסאפ שעונה לפי מדיניות החברה, ועוזר פנימי לצוות שמוצא מידע בנהלים ובמסמכים. אנחנו עובדים עם מודלים של OpenAI, Claude ו-Gemini, ומחברים את העוזר למערכות שכבר קיימות אצלכם: CRM כמו HubSpot ו-monday.com, Google Drive, Notion והאתר, בעזרת n8n ו-Make, עם הרשאות גישה ובדיקות איכות.
רוצים לבדוק איך עוזר כזה יעבוד על המידע שלכם? קראו על שירותי האוטומציה והאינטגרציות שלנו או השאירו פרטים ונחזור אליכם עם הצעה.
שאלות נפוצות על RAG
מה ההבדל בין RAG לבין אימון מחדש (fine-tuning) של מודל?
אימון מחדש משנה את המודל עצמו, ומתאים בעיקר ללימוד סגנון, פורמט או משימה חוזרת. RAG לא משנה את המודל, אלא מביא לו מידע עדכני ברגע השאלה. לכן כשהמידע משתנה, ב-RAG מספיק לעדכן את המסמכים.
האם RAG מונע "הזיות" של בינה מלאכותית?
RAG מצמצם אותן משמעותית, כי המודל עונה על סמך מקורות ולא רק על סמך הזיכרון שלו. אבל הוא לא מבטל אותן לגמרי: מסמך לא מעודכן או קטע לא מתאים עדיין יכולים להוביל לתשובה שגויה. לכן חשוב לבדוק את המערכת ולהציג מקורות.
אילו מקורות מידע אפשר לחבר למערכת RAG?
כמעט כל מקור טקסטואלי: קבצי PDF ו-Word, עמודי אתר, שאלות נפוצות, Google Drive, Notion, מסדי נתונים ומערכות CRM. מה שחשוב הוא שהמידע יהיה מעודכן ומסודר.
האם המידע של העסק נשאר מאובטח?
זה תלוי בארכיטקטורה. במערכת שנבנתה נכון מגדירים הרשאות גישה לכל משתמש, בוחרים ספקי מודלים עם מדיניות ברורה לשימוש בנתונים, ומגבילים את הבוט רק למסמכים שמותר לו לראות.
האם RAG עובד בעברית?
כן. מודלי אמבדינגים רב-לשוניים ומודלי שפה מודרניים מתמודדים היטב עם עברית. מומלץ לבדוק את המערכת על שאלות אמיתיות בעברית, כולל ניסוחים שונים ומונחים מקצועיים של התחום שלכם.